در نگاه اول، شبکه در یک کارخانه مدرن هوش مصنوعی ممکن است بسیار شبیه به یک شبکه سنتی مرکز داده به نظر برسد. BGP، ECMP، سوئیچهای شعاعی بزرگ، پارچههای Clos، و در بسیاری از محیطهای اترنت، فناوریهای آشنا مانند EVPN-VXLAN را خواهید دید.
این ممکن است شباهت زیادی به شبکه های مرکز داده ای داشته باشد که ما سال ها است که می سازیم، و از بسیاری جهات اینطور است. تفاوت این نیست که هوش مصنوعی به طور ناگهانی شبکه سنتی مراکز داده را با چیزی کاملا جدید جایگزین می کند. در عوض، هوش مصنوعی تغییر می کند آنچه از شبکه خواسته می شود انجام دهد.
به عبارت دیگر، تفاوت های فنی در طراحی و پیکربندی به کنار، تفاوت واقعی که باید درک کنید، تفاوت واقعی است. برهنه در شبکه
یک مرکز داده سنتی مدرن چگونه به نظر می رسد
ابتدا باید «سنتی» را تعریف کنیم.
یک مرکز داده مدرن در سال 2026 لزوماً به معنای معماری های اصلی دسترسی و تجمیع قدیمی نیست که بسیاری از مهندسان شبکه با آن بزرگ شده اند (از جمله خودم). مراکز داده بزرگ سازمانی و ابری قبلاً به پارچه های Clos مبتنی بر IP منتقل شده اند که معمولاً به عنوان معماری برگ استفاده می شوند.
سرورها و دستگاهها به سوئیچهای برگ متصل میشوند، هر برگ به هر ستون فقرات متصل میشود، و لایه 3 ECMP مسیرهای متعددی را با هزینه برابر از طریق پارچه فراهم میکند. افزودن برگ ها ظرفیت نقطه پایانی را افزایش می دهد و افزودن سنبله ها پهنای باند موجود پارچه را افزایش می دهد.
علاوه بر این ساختار IP، EVPN-VXLAN به یک معماری مجازی سازی شبکه رایج تبدیل شده است. بستر اتصال IP بین VTEP ها را فراهم می کند. VXLAN کپسوله سازی و تقسیم بندی شبکه را فراهم می کند و MP-BGP EVPN اطلاعات دسترسی به MAC و IP را از طریق صفحه کنترل توزیع می کند. اپراتورها می توانند به جای گسترش VLAN های فیزیکی در کل مرکز داده، شبکه های منطقی لایه 2 و لایه 3 را روی یک فابریک IP مسیریابی شده ایجاد کنند.
این معماری برای بارهای کاری معمولی مانند خوشه های مجازی سازی، پلتفرم های Kubernetes، پایگاه های داده، برنامه های کاربردی وب و سرویس های معمولی سازمانی فوق العاده خوب عمل می کند. در یک مرکز داده سنتی، شبکه اساساً برای ایجاد ارتباط بین برنامهها، خدمات، کاربران و ذخیرهسازی طراحی شده است.
همچنین، مراکز داده مدرن در حال حاضر ترافیک زیادی از شرق به غرب را حمل می کنند. میکروسرویسها با سایر ریزسرویسها ارتباط برقرار میکنند، برنامههای کاربردی پایگاههای داده توزیع شده و سیستمهای ذخیرهسازی را جستجو میکنند، و ماشینهای مجازی و کانتینرها در میان رکها ارتباط برقرار میکنند. توصیف قدیمی مرکز داده به عنوان ترافیک در درجه اول از شمال به جنوب، سال هاست که بسیاری از محیط ها را به طور دقیق توصیف نکرده است.
آنچه با هوش مصنوعی در حال تغییر است فقط جهت ترافیک نیست. این ماهیت این ترافیک و ارتباط آن با حجم کار است. در یک خوشه GPU بزرگ، شبکه بخشی از خود سیستم محاسباتی توزیع شده است.
هوش مصنوعی ترافیک شرق به غرب را به سطح دیگری می برد
آموزش هوش مصنوعی در مقیاس بزرگ هزاران (یا دهها هزار) GPU را میگیرد و سعی میکند آنها را مانند یک سیستم محاسباتی عظیم رفتار کند. به جای اجرای بارهای کاری عمدتاً مستقل، GPUها به طور مکرر در طول یادگیری توزیع شده از طریق عملیات ارتباط جمعی مانند AllReduce، AllGather، ReduceScatter و All-to-All تبادل اطلاعات می کنند. این یک بار غیرمعمول در شبکه ایجاد می کند.
هزاران پردازنده گرافیکی می توانند به طور همزمان با یکدیگر ارتباط برقرار کنند و حجم عظیمی از داده را بین سرورها و رک ها به عنوان بخشی از عملیات محاسباتی یکسان منتقل کنند. اینها فقط جریان های مستقلی از برنامه های کاربردی نیستند که مانند یک مرکز داده سنتی از شرق به غرب سفر می کنند. در یک شبکه مرکز داده هوش مصنوعی، ارتباطات به عنوان بخشی از همان محاسبات توزیع شده هماهنگ و اغلب به شدت هماهنگ می شود.
تصور کنید 1024 GPU در یک عملیات AllReduce شرکت می کنند. هر GPU یک محاسبه را به صورت محلی انجام می دهد و سپس داده ها را با سایر GPU ها مبادله می کند تا نتایج را بتوان قبل از ادامه مرحله بعدی محاسبه، ترکیب و توزیع کرد.
اگر یک GPU یا مسیر شبکه در طول یک عملیات جمعی کند شود، پیشرفت در عملیات بزرگتر ممکن است توسط آن شرکت کننده کندتر محدود شود. نتیجه ممکن است همگام سازی کندتر و زمان تکمیل کار طولانی تر باشد.
شبکه به طور موثر بخشی از مکانیسم هماهنگ سازی یک سیستم محاسباتی توزیع شده شده است و این ارتباط مستقیمی بین عملکرد شبکه و عملکرد محاسباتی ایجاد می کند:
پهنای باند مهم است زیرا GPU ها باید مقادیر زیادی داده را مبادله کنند. تأخیر اهمیت دارد زیرا ارتباطات اغلب در مسیر بحرانی حجم کار رخ می دهد. از دست دادن بسته مهم است زیرا بازیابی می تواند جریان کارآمد داده ها را مختل کند. ازدحام مهم است زیرا ترافیک همگامسازی شده میتواند نقاط داغ و انفجار ایجاد کند. و توالی مهم است زیرا عملکرد کندترین شرکت کننده می تواند بر عملیات جمعی بزرگتر تأثیر بگذارد.
بنابراین مشکل فقط این نیست که هوش مصنوعی ترافیک بیشتری را در جهت شرق به غرب ایجاد می کند. ترافیک شرقی-غربی با فرکانس بالا، هماهنگ و حساس به عملکرد ایجاد می کند که مستقیماً با پیشرفت محاسبات مرتبط است.
وقتی نقاط پایانی هزاران شتاب دهنده بسیار گران قیمت باشند، یک معادله اقتصادی بسیار متفاوت است.
شبکه هوش مصنوعی بخشی از کامپیوتر است
به همین دلیل است که کارخانههای بزرگ هوش مصنوعی و نئوکلادها اغلب شبکهای دارند که به طور خاص به ارتباطات GPU به GPU اختصاص داده شده است. این ساختار محاسباتی بکاند GPU به GPU معمولاً جدا از شبکه جلویی است که برای سرویسهای مرسومتر مانند دسترسی به حجم کاری، ارتباطات API، اتصال به اینترنت و سایر ترافیک برنامهها استفاده میشود. علاوه بر این، فضای ذخیرهسازی میتواند شبکه خاص خود را داشته باشد، به غیر از چندین مستأجر سرویس، شبکههای خارج از باند، و برای neocloud، چندین مستأجر شخص ثالث.
بنابراین، معماریهای هوش مصنوعی میتوانند شامل چندین پارچه مجزا با تخصصیتر از آنچه معمولاً در مراکز داده معمولی میبینیم، باشد.
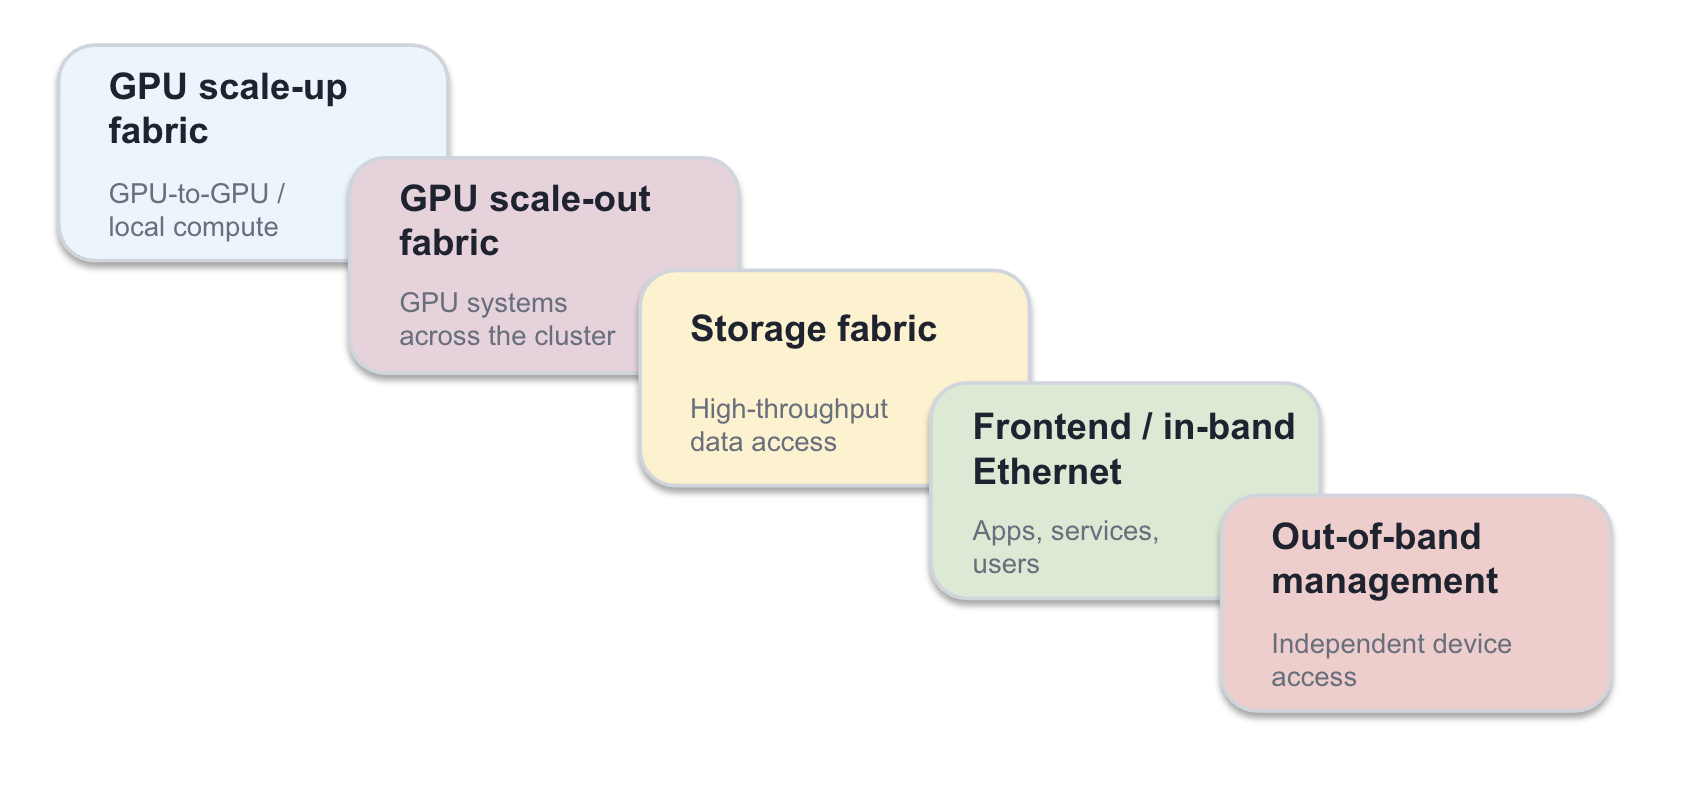
این تفاوت یکی از اولین تفاوت های عمده معماری بین مراکز داده مرسوم و کارخانه های هوش مصنوعی است.
بزرگنمایی و کوچک نمایی
بزرگنمایی کنید
یک لایه شبکه دیگر وجود دارد که واقعاً معادلی در معماری شبکه های مرسوم مرکز داده ندارد. در سیستمهای GPU مدرن، شتابدهندهها از طریق اتصالات با پهنای باند بسیار بالا مانند NVIDIA NVLink ارتباط برقرار میکنند. با سیستمهای در مقیاس رک، مانند معماریهای NVL72، این کوپلینگ را میتوان در بسیاری از GPUهای موجود در رک گسترش داد.
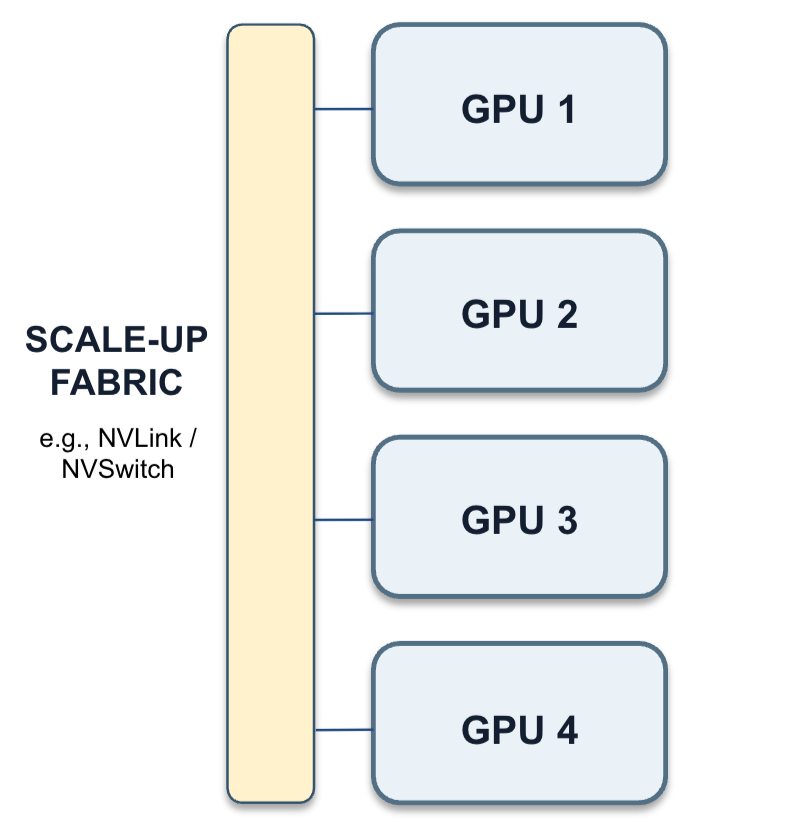
این مقیاس پهنای باند بسیار بالا و اتصال با تأخیر کم را فراهم می کند که GPU ها برای برقراری ارتباط با حداقل سربار نیاز دارند.
برخلاف شبکههای معمولی، این پیوندها بسیاری از پشته شبکه سنتی را حذف میکنند و از مکانیسمهایی مانند کنترل جریان مبتنی بر اعتبار و بازیابی خطا در سطح پیوند استفاده میکنند.
با افزایش سرعت پیوند، فناوری هایی مانند سیگنالینگ PAM4، FEC و پردازش سیگنال، حفظ تأخیر قابل پیش بینی و قطعی را بسیار چالش برانگیز می کند.
مقیاس بندی
این شبکه در مقیاس بزرگ، سیستم های GPU را در خوشه هوش مصنوعی بزرگتر با استفاده از فناوری هایی مانند اترنت با RoCE یا InfiniBand متصل می کند. بر خلاف اتصالهای کوچکشده بههمپیوسته، طرحهای مقیاسپذیر، مقیاسپذیری و انعطافپذیری را در اولویت قرار میدهند در حالی که به پهنای باند بسیار بالا و تأخیر پیوسته کم نیاز دارند.
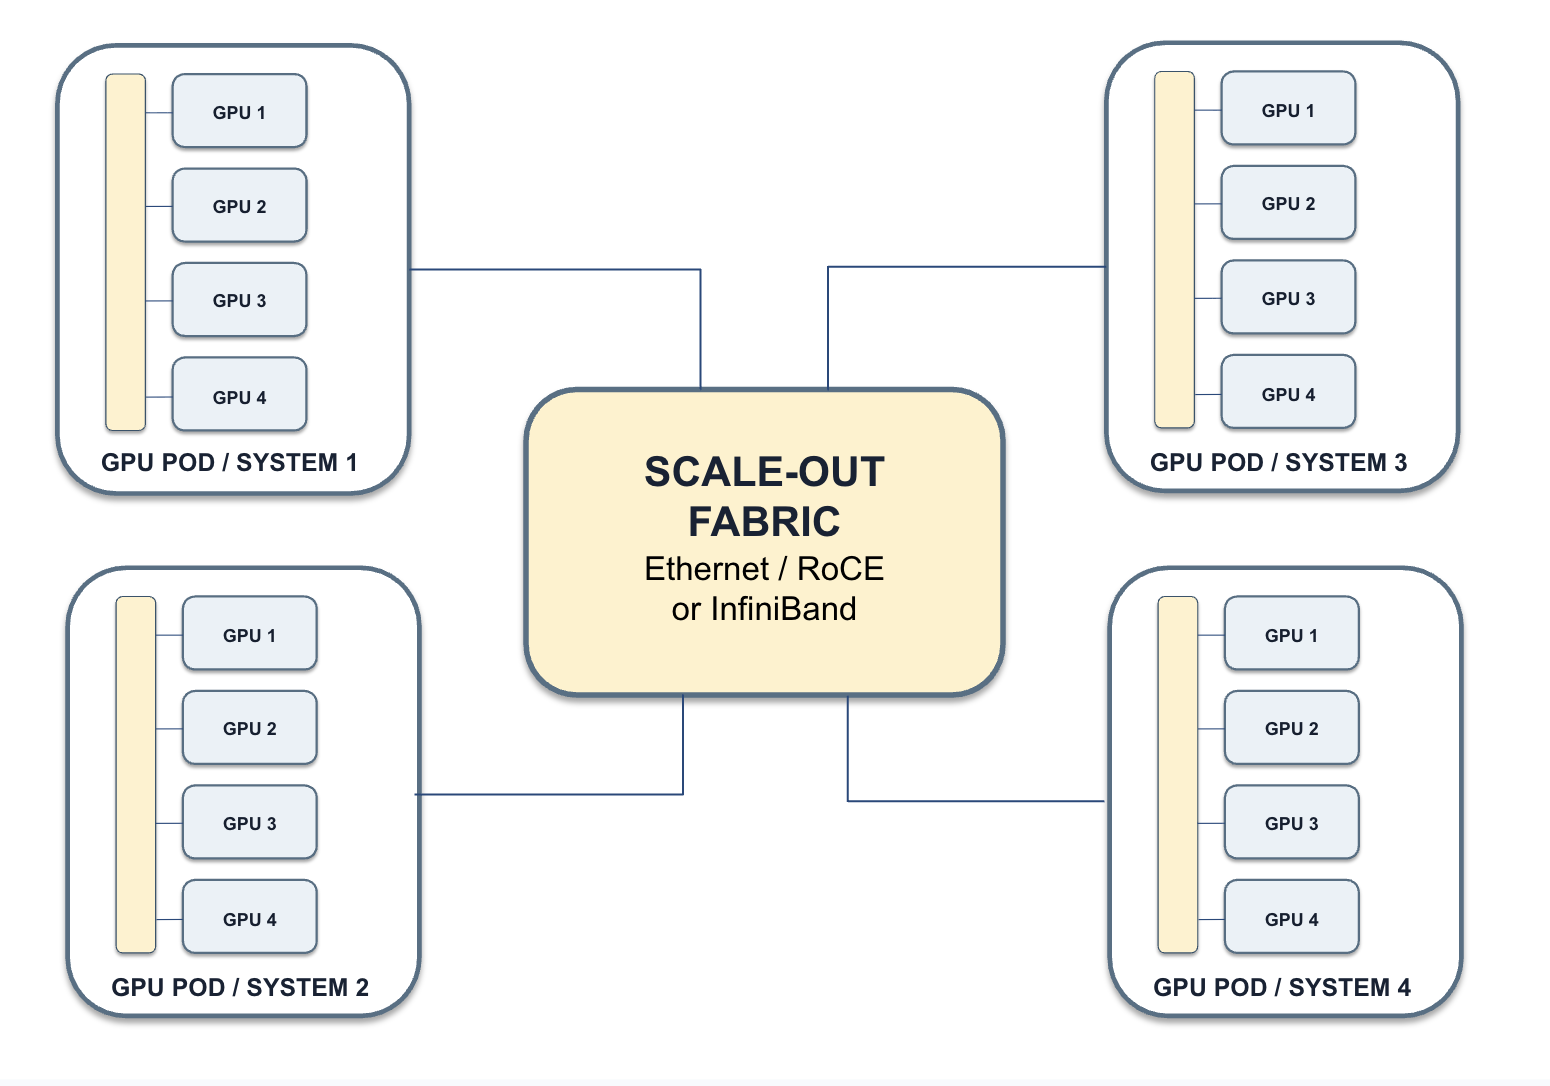
از آنجایی که بارهای کاری هوش مصنوعی توزیع شده اغلب داده ها را مبادله و همگام می کنند، ازدحام، از دست دادن بسته ها و تأخیر می تواند GPU ها را بیکار کند. فناوریهایی مانند RDMA، ECN، PFC و مسیریابی تطبیقی به کارآمد و قابل پیشبینی ارتباط در خوشههای بزرگ حاوی هزاران GPU کمک میکنند.
تفاوت مهم این است که مقیاس گذاری و کوچک کردن بخش های مختلف یک مشکل را حل می کند. Scale-out GPU ها را تا حد امکان در یک سیستم یا کابینت به هم متصل می کند، در حالی که scale-out آن سیستم ها را در خوشه بزرگتر به هم متصل می کند.
آنها با هم سلسله مراتبی از اتصال GPU را ایجاد می کنند که واقعاً در یک مرکز داده معمولی وجود ندارد. بنابراین، یک کارخانه هوش مصنوعی می تواند یک پارچه مقیاس پذیر بسیار سریع در سیستم های GPU، یک پارچه مقیاس پذیر جداگانه که این سیستم ها را به هم متصل می کند، و شبکه های اضافی برای ذخیره سازی، اتصال رابط و مدیریت داشته باشد.
شبکه های بهینه شده برای ریل
توپولوژی فیزیکی نیز می تواند تغییر کند. در یک شبکه پایه برگ سنتی، یک سرور ممکن است دو کارت شبکه متصل به یک جفت سوئیچ برگ اضافی داشته باشد. هدف اتصال مداوم به سرور است. سیستمهای GPU میتوانند رابطهای شبکهای با سرعت بسیار بالایی داشته باشند، زیرا واحدهای گرافیکی جداگانه یا گروههای گرافیکی به پهنای باند زیادی نیاز دارند.
این منجر به طراحی های بهینه ریل می شود. تصور کنید که هر سرور GPU دارای هشت رابط شبکه با GPU است. به جای اتصال تصادفی هر هشت رابط در فابریک، NIC 0 از هر سرور را می توان به یک مجموعه سوئیچ برگ، NIC 1 به دیگری و غیره متصل کرد.
هر یک از این گروه ها یک ریل را تشکیل می دهند. بنابراین، توپولوژی را می توان با نحوه توزیع ترافیک توسط GPU و کتابخانه های ارتباط جمعی هماهنگ کرد. طراحی شبکه فیزیکی ارتباط نزدیکی با معماری خود سیستم محاسباتی دارد. این با طراحی یک شبکه سرور دسترسی معمولی بسیار متفاوت است.
اشتراک بیش از حد در حال گران شدن است
شبکههای مرکز داده سنتی اغلب از اشتراک بیش از حد استفاده میکنند زیرا هر نقطه پایانی به حداکثر پهنای باند همزمان نیاز ندارد. نسبت دقیق ممکن است متفاوت باشد، اما نکته اینجاست که شبکههای مرکز داده سنتی میتوانند اشتراک بیش از حد قابل توجهی را تحمل کنند، زیرا انتظار نمیرود هر نقطه پایانی دادههای نرخ خط را همزمان ارسال کند. از سوی دیگر، پارچههای آموزشی بزرگ هوش مصنوعی اغلب برای پهنای باند 1:1 یا نزدیک به 1:1 طراحی میشوند و اشتراک بیش از حد در بافت گرافیکی مقیاسپذیر را به حداقل میرسانند یا حذف میکنند.
در یک شبکه مرکز داده هوش مصنوعی، یک گلوگاه فقط باعث کاهش سرعت چند جریان نمی شود. این می تواند تعداد زیادی از پردازنده های گرافیکی بسیار گران قیمت را در حالت بیکار قرار دهد که شیوع پارچه های غیر مسدود یا تقریباً مسدود کننده را توضیح می دهد.
این بدان معناست که اقتصاد شبکههای مرکز داده سنتی و شبکههای خوشهای هوش مصنوعی متفاوت است. در یک شبکه سنتی، ظرفیت سوئیچینگ اضافی یک هزینه زیرساخت است، اما در یک کارخانه هوش مصنوعی، ظرفیت ناکافی شبکه میتواند به طور قابلتوجهی در درآمد از دست رفته هزینه بیشتری داشته باشد، زیرا پردازندههای گرافیکی بیکار هستند.
NIC بخشی از معماری می شود
NIC سرور نیز بسیار مهمتر است. سرورهای سنتی معمولاً از NIC های اترنت برای اتصال سیستم عامل به شبکه استفاده می کنند. سیستمهای هوش مصنوعی اغلب از آداپتورهای پیچیدهای مانند NVIDIA ConnectX NIC، BlueField DPU و SuperNIC استفاده میکنند که مستقیماً در RDMA، مدیریت ازدحام، تلهمتری، امنیت، جداسازی و تخلیه زیرساخت دخالت دارند.
این یک سیستم جفت شده محکم تری ایجاد می کند تا نقطه پایانی و ساختار شبکه را نتوان به عنوان حوزه های مهندسی کاملاً مجزا در نظر گرفت. این همچنین به این معنی است که عیبیابی یک مشکل شبکه هوش مصنوعی ممکن است نیاز به همبستگی تلهمتری سوئیچ، شمارندههای NIC، رفتار GPU، عملکرد ارتباط جمعی، سلامت نوری و قرار دادن بار کاری داشته باشد.
ساخت شبکه نیز در حال تغییر است
یک شبکه مرسوم مرکز داده تا حد زیادی می تواند به عنوان حوزه زیرساختی خود طراحی شود. پارچه را طراحی کنید، لایه زیرین و روکش را به کار ببرید، سرویس ها و خط مشی ها را پیکربندی کنید، آن را تایید کنید و سرورها را به هم متصل کنید.
اتوماسیون مدرن این فرآیند را با زیرساختهایی مانند کد، دستگاه و قالبهای پیکربندی، خطوط لوله CI/CD، سیستمهای مبتنی بر هدف، و اعتبارسنجی مستمر بهبود میبخشد، که همگی در شبکههای مرکز داده مرسوم به خوبی تثبیت شدهاند.
یک کارخانه هوش مصنوعی سطح دیگری از هماهنگی را اضافه می کند. توپولوژی GPU، قرار دادن NIC، پایه سوئیچ، طراحی ریل، اپتیک، کابل کشی، معماری ذخیره سازی، الگوهای ارتباط جمعی، در دسترس بودن توان، چگالی رک و اشتراک بیش از حد شبکه، همگی بر یکدیگر تأثیر می گذارند.
برای یک کارخانه هوش مصنوعی، نمی توانید شبکه را به طور مستقل طراحی کنید و سپس سرورهای GPU را بعداً متصل کنید. شبکه باید از همان ابتدا با معماری محاسباتی در ذهن طراحی شود.
خوشههای بزرگ AI GPU نیز اغلب حول واحدهای تکراری زیرساخت ساخته میشوند. یک ماژول یا پاد میتواند تعداد و نوع خاصی از سیستمهای GPU را به همراه سوئیچها، پورتها، اپتیک، کابلکشی، اتصال ذخیرهسازی و توان مورد نیاز برای پشتیبانی از آنها تعریف کند. بسط به جای طراحی مستقل هر بخش جدید از خوشه، استقرار واحدهای تایید شده اضافی است.
برای نئوکلادها، مشتری نهایی عامل دیگری است. Neocloud فقط یک خوشه GPU بزرگ نمی سازد. درست مانند یک ابر عمومی، باید مکرراً بخشهایی از آن زیرساخت را بین مشتریان مختلف، به طور بالقوه در سراسر اترنت، InfiniBand، ذخیرهسازی، شبکه میزبان و دامنههای مقیاس جدیدتر توزیع کند. بنابراین، تدارکات به جای یک پروژه یکباره برای ایجاد یک شبکه، به یک گردش کار عملیاتی مداوم تبدیل می شود.
عملیات روز دوم بخشی از اقتصاد GPU است
عملیات روز 2 ممکن است بزرگترین تفاوت عملیاتی باشد. عملیات شبکه سنتی به شدت بر در دسترس بودن و عملکرد شبکه متمرکز است. با زیرساخت هوش مصنوعی، این کافی نیست. یک شبکه هوش مصنوعی میتواند از نظر فنی “بالا” باشد در حالی که به اندازه کافی ضعیف عمل می کند تا بر اقتصاد خوشه تاثیر بگذارد.
یک فرستنده نوری کثیف، لینک تخریب شده، کانون شلوغ، توزیع ضعیف ترافیک، تنظیمات اشتباه پارامترهای RoCE، یا یک ریل با عملکرد ضعیف میتواند عملکرد ارتباط جمعی را بدون ایجاد قطعی سنتی کاهش دهد.
این امر نظارت بر عملکرد را بسیار مهم تر می کند. اپراتورها به دید در سوئیچ ها و رابط ها نیاز دارند، اما به طور بالقوه در SuperNIC ها، DPU ها، GPU ها، رفتار ارتباط جمعی، استفاده از صف، رویدادهای تراکم، عملکرد نوری و رابطه بین رفتار شبکه و بار، به دید بالقوه نیاز دارند.
فواصل نظرسنجی سنتی ممکن است رویدادهای گذرا را نیز از دست بدهند. یک رویداد ازدحام که میلیثانیه یا میکروثانیه طول میکشد احتمالاً مدتها قبل از چرخه نظرسنجی بعدی SNMP پاک میشود، حتی اگر بر حجم کاری هوش مصنوعی تأثیر گذاشته باشد. نظرسنجی سنتی می تواند به راحتی این شرایط گذرا را از دست بدهد و اهمیت تله متری جریان، شمارشگرهای سخت افزاری، تله متری صف و تراکم و سایر مکانیسم های نظارت با وضوح بالا را افزایش دهد.
در نتیجه، عملیات کمتر شبیه مدیریت دستگاه سنتی و بیشتر شبیه کار با یک پارچه محاسباتی توزیع شده است. بنابراین، اپراتورها به جای اینکه بپرسند آیا شبکه راهاندازی و راهاندازی شده است، میپرسند که آیا شبکه به خوشههای GPU اجازه میدهد تا همانطور که طراحی شدهاند کار کنند.
اصول اولیه یکسان، اما مشکل مهندسی متفاوت است
کارخانه های هوش مصنوعی دهه ها دانش مرکز داده شبکه را باطل نمی کنند. BGP همچنان مهم است، مانند پروژه های Clos، ECMP، نظم کابلی، دامنه های مسیریابی، اتوماسیون، شبکه های مدیریت، EVPN-VXLAN و غیره.
تفاوت واقعی این است که هدف بهینه سازی تغییر کرده است. یک شبکه مرسوم مرکز داده اساساً برای ارائه اتصال مقیاس پذیر و انعطاف پذیر بین سیستم های محاسباتی طراحی شده است، در حالی که یک شبکه فابریک AI طراحی شده است تا هزاران GPU را به عنوان یک سیستم محاسباتی واحد رفتار کند.
میزان پهنای باند ارائه شده، نحوه ساخت توپولوژی، نحوه مشارکت نقاط پایانی در شبکه، نحوه مدیریت ازدحام، نحوه جداسازی مستاجران، نحوه نظارت بر عملکرد و نحوه استقرار و مدیریت زیرساخت را تغییر می دهد.
برای مهندسان شبکه، این شاید مفیدترین راه برای درک انتقال باشد. ما شبکه مرسوم مرکز داده را دور نمی اندازیم. در عوض، ما بسیاری از فنآوریها و اصول مهندسی را در نظر میگیریم و آنها را در حجم کاری که خود شبکه بخشی از رایانه شده است، به کار میبریم.
متشکرم
فیل