برای دههها، معماران شبکه، شبکههای مرکز داده را عمدتاً پیرامون ترافیک برنامهها و ذخیرهسازی طراحی کردهاند. این شبکه چه از برنامههای سازمانی، چه از خدمات وب، چه پلتفرمهای مجازیسازی یا بارهای کاری ابری پشتیبانی کند، مکانیسم انتقالی بود که کاربران، برنامهها و دادهها را به هم متصل میکرد.
الگوهای ترافیک با جریان های ارتباطی شمال-جنوب، مبادلات کاربردی شرقی-غربی قابل پیش بینی، و جفت نسبتا ضعیف بین محاسبات و عملکرد شبکه مشخص شدند. محیط های محاسباتی با کارایی بالا تا حدودی متفاوت هستند و بر پهنای باند فوق العاده بالا، تأخیر کم و ارتباطات کارآمد بین گره ها برای بارهای کاری توزیع شده تأکید می کنند. با این حال، زیرساختهای هوش مصنوعی مدرن، یک مدل اساسا متفاوت را معرفی میکنند.
خوشه های آموزشی هوش مصنوعی مدرن متشکل از صدها، هزاران و حتی ده ها هزار شتاب دهنده هستند که به عنوان یک سیستم محاسباتی توزیع شده واحد عمل می کنند. این شتابدهندهها بهجای اجرای بارهای کاری مستقل، بهطور مداوم شیبها، پارامترها، فعالسازیها، جاسازیها و اطلاعات زمانبندی را در طول آموزش و استنتاج مبادله میکنند.
(شتاب دهنده هر وسیله محاسباتی تخصصی مانند GPU یا TPU است که برای عملیات عددی موازی مانند ضرب ماتریس، عملیات تانسور و محاسبات برداری بهینه شده است.)
در نتیجه، ترافیک غالب در یک خوشه هوش مصنوعی، ترافیک برنامه سنتی نیست. در عوض، این ترافیک ارتباطی است که توسط خود سیستم محاسباتی توزیع شده ایجاد می شود. این مبادلات ارتباطی به عنوان شناخته می شوند ارتباطات جمعی.
ارتباطات جمعی برای دهه ها در دنیای محاسبات با کارایی بالا وجود داشته است. با این حال، مقیاس سیستمهای هوش مصنوعی مدرن، آنها را از یک مفهوم تخصصی HPC به یک محرک اصلی معماری شبکه مرکز داده تبدیل کرده است.
امروزه توپولوژی شبکه، مدیریت ازدحام، تعادل بار، زیرساخت نوری، تراکم کابلکشی و حتی قرارگیری فیزیکی کابینتها (به طور جدی) به طور فزایندهای حول عملکرد ارتباط جمعی بهینه میشوند. عملیات جمعی توضیح میدهد که چرا شبکههای هوش مصنوعی به پهنای باند دوقسمتی بسیار بالایی نیاز دارند، چرا ترافیک شرق به غرب بر استفاده از فابریک غالب است، و چرا ناکارآمدیهای کوچک شبکه میتواند به میلیونها دلار در کاهش عملکرد شتابدهنده تبدیل شود.
چالش یک مدل اما تعداد زیادی پردازنده گرافیکی
برای درک الگوهای ترافیک ارتباط جمعی، درک دلیل وجود آنها در وهله اول مهم است.
بزرگترین مدلهای هوش مصنوعی در حال تولید امروزه حاوی صدها میلیارد یا حتی تریلیونها پارامتر هستند. مجموعه دادههای آموزشی اغلب تریلیونها توکن را در بر میگیرد و الزامات محاسباتی برای این نوع بار کاری بسیار فراتر از تواناییهای هر شتابدهندهای است. بنابراین، سیستمهای هوش مصنوعی هم محاسبات و هم حافظه را در تعداد زیادی از GPU توزیع میکنند.
یک کار آموزشی یک مدل میتواند صدها یا هزاران شتابدهنده را با بخشهایی از مدل که در چندین دستگاه شبکه توزیع شده است، در بر گیرد. مجموعه داده ها بین کارگران توزیع می شود و نتایج محاسباتی میانی به طور مداوم در طول فرآیند آموزش رد و بدل می شوند.
(کارگر در این زمینه فقط یک سرور واحد با یک GPU است که بخش کوچکی از بار آموزشی را اجرا می کند.)
به خصوص برای شبکه، این یک چالش بزرگ است. در حالی که حجم کار توزیع می شود، خود مدل باید به عنوان یک سیستم واحد و منسجم رفتار کند. یک سیستم توزیع شده باید سازگاری کافی از حالت مدل و نتایج محاسبات میانی را حفظ کند تا یادگیری بتواند به درستی پیشرفت کند. این شامل گرادیان هایی است که باید همگام شوند و پارامترهایی که باید به اشتراک گذاشته شوند. همچنین، فعالسازیها باید مبادله شوند و نتایج میانی باید تجمیع و توزیع شوند. به عبارت دیگر، این نوع توزیع انبوه در ارتباطات شبکه ای و ارتباطات جمعی مشکل ایجاد می کند مکانیسم هایی هستند که برای حل آن استفاده می شوند.
ارتباطات جمعی چه می کند؟
در سطح بالا، عملیات ارتباط جمعی به گروههایی از شتابدهندهها اجازه میدهد تا اطلاعات را بسیار کارآمد مبادله، تجمیع، همگامسازی و منتشر کنند. بهجای تلقی ارتباطات بهعنوان مجموعهای از جریانهای نقطهبهنقطه مستقل، عملیات جمعی، ارتباط بین کل گروههای بازیگران را هماهنگ میکند. در همان زمان.
این بدان معنی است که شبکه دیگر به سادگی ترافیک برنامه را منتقل نمی کند. در عوض، شبکه یک شرکت کننده فعال در خود فرآیند محاسباتی است. همانطور که جان گیج از Sun Microsystems در سال 1984 گفت: “شبکه کامپیوتر است.”
مهمترین عملیات ارتباط جمعی
اگرچه عملیات جمعی متعددی وجود دارد (که ما در اینجا به بسیاری از آنها نمی پردازیم)، تعداد نسبتا کمی برای اکثر ارتباطات در خوشه های هوش مصنوعی مدرن استفاده می شود. متداول ترین چارچوب مورد استفاده کتابخانه ارتباطات جمعی NVIDIA (NCCL) است.
پخش
پخش عملیات، داده ها را از یک منبع بین هر شرکت کننده در یک گروه ارتباطی توزیع می کند.
یک مثال ساده زمانی است که یک GPU پارامترهای مدل یا اطلاعات پیکربندی را از یک فرآیند واحد به بسیاری از GPUهای کارگر توزیع می کند.
در تصویر سمت چپ، میبینید که GPU 0 (ریشه) همان دادهها را به تمام پردازندههای گرافیکی دیگر ارسال میکند.
در تئوری، پخش یک مدل ارتباطی یک به چند است. با افزایش اندازه خوشه، استقرار کارآمد ترافیک پخش بسیار مهم می شود، زیرا تکرار ترافیک به صورت جداگانه به هر مقصد در مقیاس بسیار گران می شود.
خودتو جمع کن
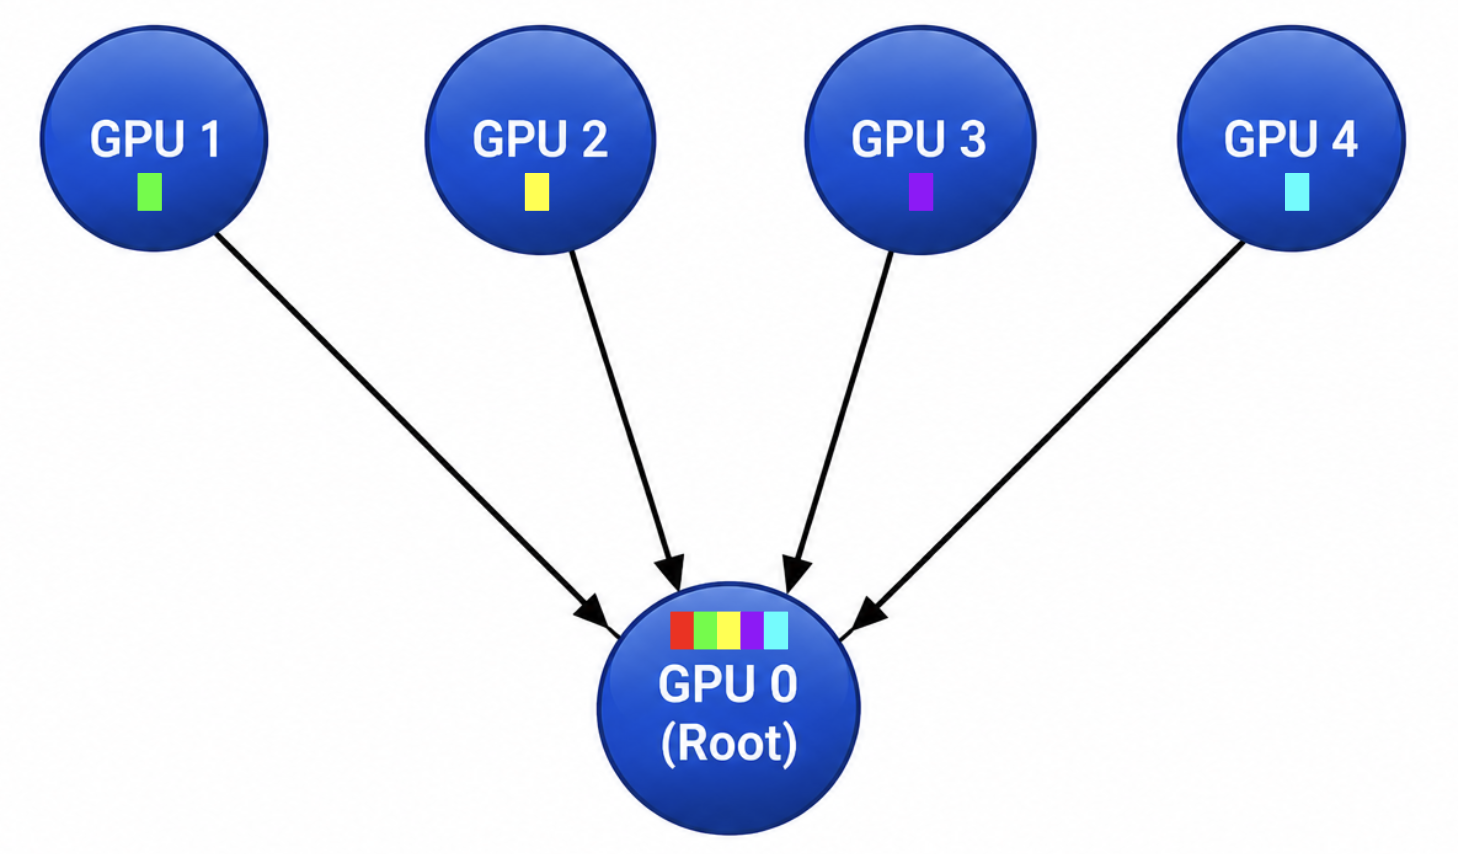
خودتو جمع کن عملیات برعکس پخش انجام می شود.
در تصویر سمت راست، میتوانید GPU 1-4 را ببینید که دادههای فردی را برای جمعآوری به GPU 0 ارسال میکنند.
به طور کلی، در عملیات جمع آوری، چندین بازیگر اطلاعات را به یک مقصد واحد می فرستند که در آنجا نتایج جمع آوری می شود. عملیات تجمیع اغلب در فعالیتهای تجمیع داده و هماهنگی در حجمهای کاری هوش مصنوعی ظاهر میشود.
همه جمع شوند
همه جمع شوند فراتر از جمع آوری است. در یک عملیات All-Gather، هر شرکتکننده بخشی از دادهها را ارائه میکند و نتیجه نهایی برای هر شرکتکننده توزیع میشود. به عنوان مثال، هشت پردازنده گرافیکی را تصور کنید که هر یک یک هشتم تانسور را ذخیره می کند. در یک عملیات AllGather، هر هشت پردازنده گرافیکی اطلاعات مورد نیاز برای تولید تانسور کامل را دریافت خواهند کرد. در عمل واقعی، هر GPU معمولاً دادهها را در طول هر فاز به زیر مجموعهای از همسایگان ارسال میکند.
در تصویر زیر می بینید که چگونه نتیجه این است که هر GPU مجموعه کامل داده های جمع آوری شده توسط همه شرکت کنندگان را دریافت می کند.
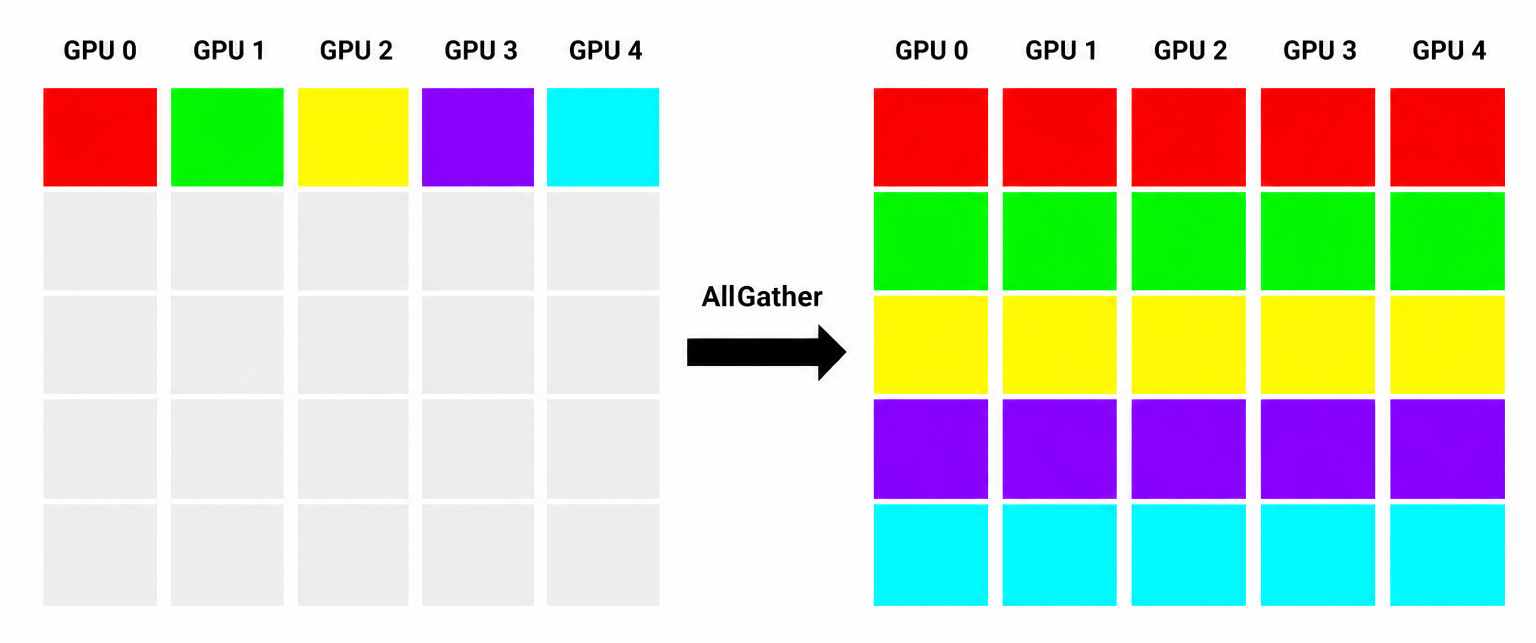
عملیات AllGather به ویژه در معماری های یادگیری تانسور-موازی رایج است و در پیاده سازی استنتاج در مقیاس بزرگ بسیار مهم است.
کاهش دهید
کاهش دهید عملیات جمع آوری اطلاعات از چندین گره با استفاده از توابع ریاضی مانند مجموع، حداقل، حداکثر، یا میانگین. بنابراین به جای پخش نتیجه، مقدار کاهش یافته به یک شرکت کننده مشخص و تعیین شده تحویل داده می شود.
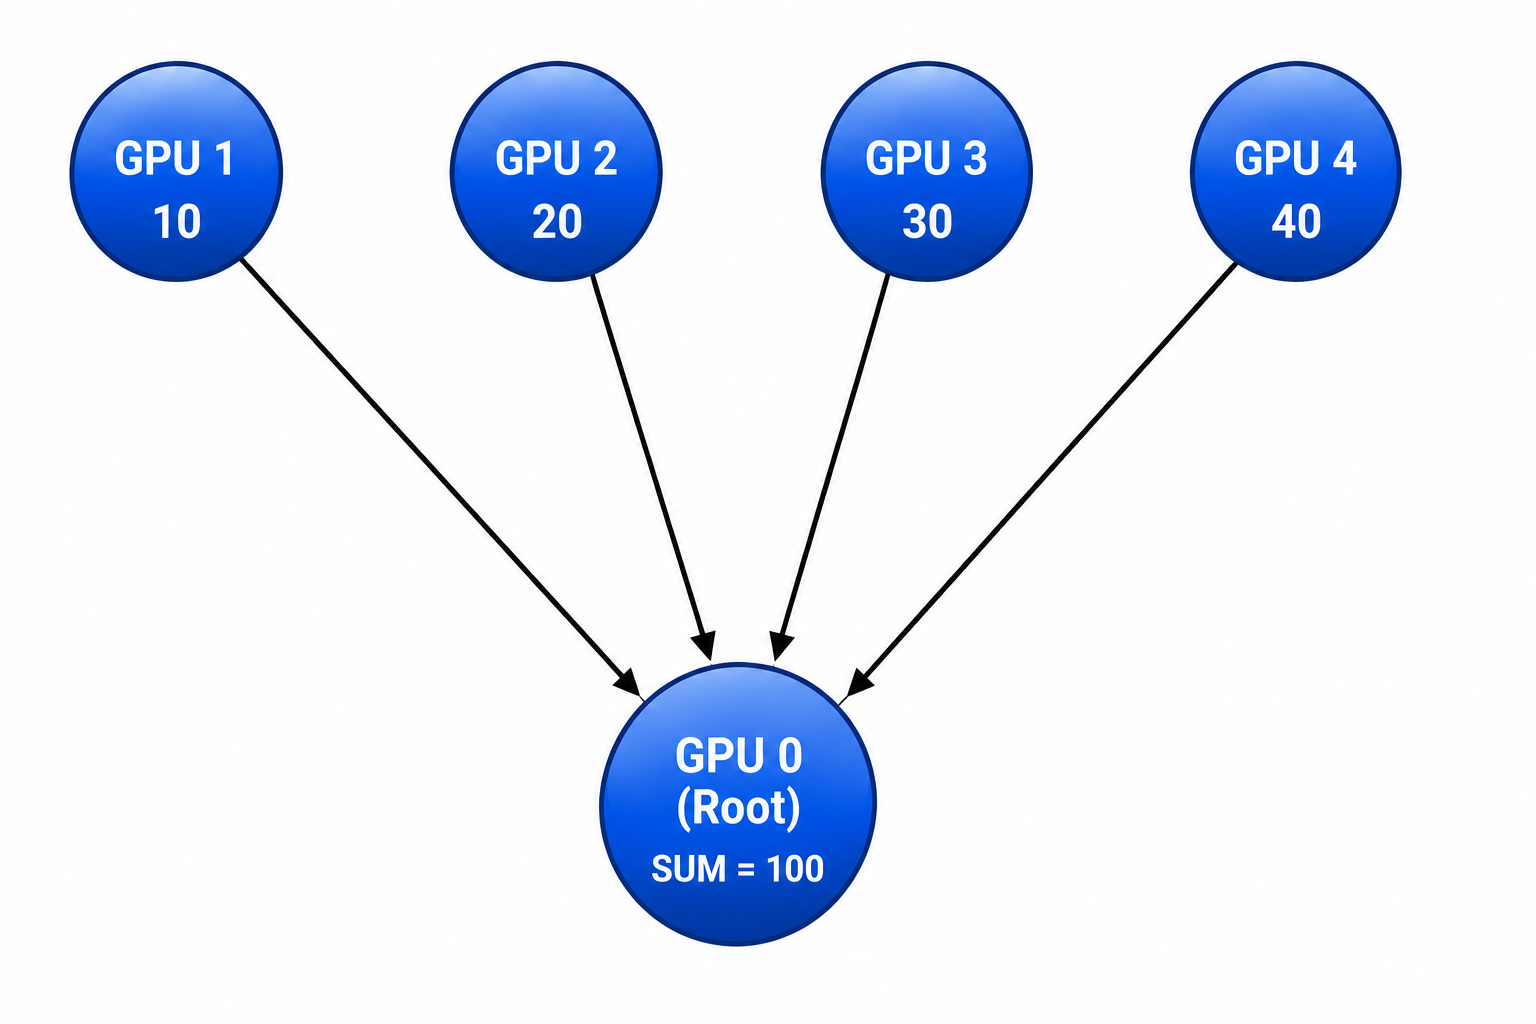
در این تصویر مثال ساده در سمت چپ، می بینید که هر GPU محاسبات جداگانه خود را انجام می دهد (به موازات سایر GPU ها) و در یک عملیات کاهش داده ها را به GPU تعیین شده ارسال می کند تا در این مورد جمع شوند.
محاسبات واقعی میتواند انواع مختلفی از عملیات باشد، و عملیات کاهش فردی معمولاً بخشی از یک سری عملیات پیچیدهتر دیگر مانند ReduceScatter یا AllReduce است.
همه کاهش
در میان تمام عملیات ارتباط جمعی، همه کاهش شاید مهمترین در یادگیری هوش مصنوعی توزیع شده باشد. هر شرکت کننده اطلاعاتی را در عملیات کاهش مشارکت می دهد. سپس مجموع حاصل به هر یک از شرکت کنندگان توزیع می شود.
در تصویر زیر میبینید که هر GPU دادهها را به یک عملیات کاهش توزیع شده اضافه میکند و مقدار کاهشیافته حاصل از آن به هر شرکتکننده توزیع میشود.

یک مثال کلاسیک از AllReduce، همگام سازی گرادیان تحت آموزش موازی داده است. هر GPU به طور مستقل شیب ها را از داده های آموزشی اختصاص داده شده خود محاسبه می کند، اما قبل از ادامه آموزش، این گرادیان ها باید بین همه کارگران شرکت کننده ترکیب و همگام شوند.
AllReduce این هماهنگ سازی را انجام می دهد و بنابراین عملکرد All-Reduce معمولاً به یک عامل اصلی در عملکرد کلی تمرین تبدیل می شود. و به ویژه در زمینه شبکه، با افزایش اندازه مدل و مقیاس های خوشه، ترافیک AllReduce اغلب به یکی از کاربران غالب پهنای باند شبکه تبدیل می شود.
همه به همه
در سطح بالا، همه به همه زمانی است که هر GPU شرکت کننده داده را به هر GPU شرکت کننده دیگری ارسال می کند. AlltoAll یکی از خواستارترین و پهنای باندترین مدل های ارتباط جمعی در یادگیری هوش مصنوعی مدرن است.
در عملیات AlltoAll چیزهای زیادی در جریان است که در تصویر زیر مشاهده می کنید. هر GPU یک قطعه داده منحصر به فرد را به هر GPU دیگری ارسال می کند و به همین ترتیب یک قطعه داده منحصر به فرد را از هر GPU دیگر دریافت می کند.
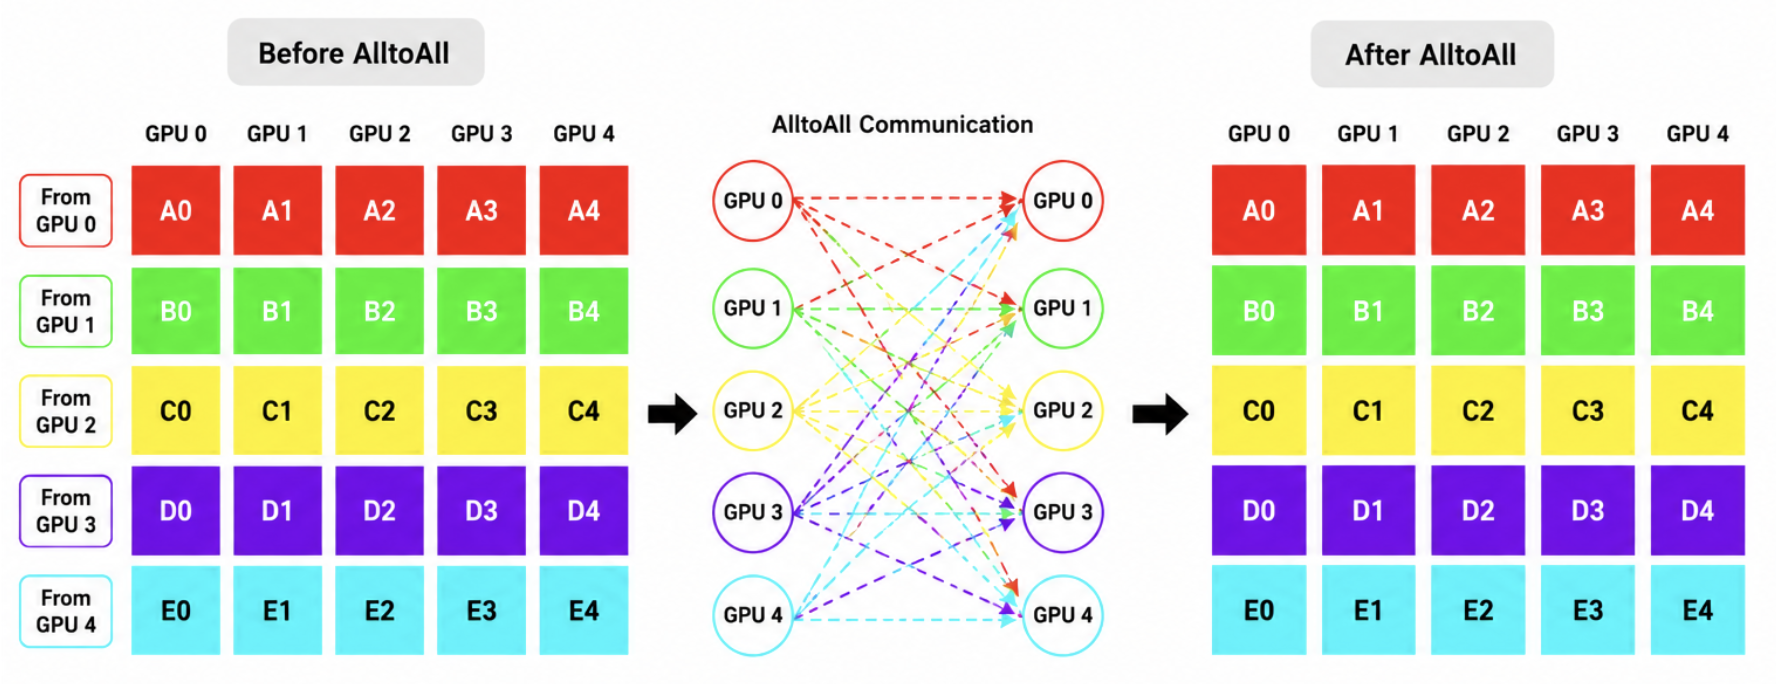
با این نوع الگوی ترافیک، مقصد مرکزی وجود ندارد. هر نقطه پایانی هم یک فرستنده و هم یک گیرنده است و نتیجه آن یک انبوه ترافیک از شرق به غرب است. این را اغلب در پیاده سازی های MOE (ترکیبی از متخصصان) می بینیم.
چرا ارتباطات جمعی بر ترافیک مرکز داده هوش مصنوعی تسلط دارد؟
پس چرا ارتباطات جمعی در شبکه های مرکز داده هوش مصنوعی اینقدر مسلط است؟ به بیان ساده، هر تکرار آموزش هوش مصنوعی معمولاً به چندین عملیات جمعی شامل هزاران شتاب دهنده نیاز دارد و این عملیات به طور مکرر در طول دوره آموزشی انجام می شود که می تواند روزها، هفته ها یا ماه ها طول بکشد. نتیجه حجم عظیمی از ترافیک شرق به غرب است.
در طول آموزش مدل در مقیاس بزرگ، اکثریت قریب به اتفاق ترافیک شبکه اغلب به طور کامل در خود خوشه باقی می ماند. ترافیک ایجاد شده توسط کاربران، سیستم های ذخیره سازی و برنامه های کاربردی خارجی تنها بخش کوچکی از کل استفاده از شبکه را نشان می دهد.
به همین دلیل است که بحث های شبکه در مورد هوش مصنوعی بر معیارهایی مانند:
- عرض نوار دو نیم شده
- استفاده از پارچه
- توالی تاخیر
- مدیریت تراکم
- عملکرد متعادل کننده بار
- زمان تکمیل جمعی
بنابراین، در مراکز داده هوش مصنوعی، شبکه برای تحویل برنامه بهینه نیست، بلکه برای کارایی ارتباط جمعی است.
رابطه بین موازی سازی و ترافیک شبکه
نکته مهمی که باید به آن توجه داشت این است که اشکال مختلف موازی سازی مدل هوش مصنوعی الگوهای ارتباطی متفاوتی را ایجاد می کنند.
به عنوان مثال، موازی سازی داده ها به شدت به عملیات AllReduce برای همگام سازی گرادیان متکی است، در حالی که موازی سازی تانسوری عملیات AllGather و ReduceScatter مکرر را ایجاد می کند زیرا تانسورها در بسیاری از شتاب دهنده ها تقسیم می شوند. موازی خطوط لوله، تبادل مداوم فعالسازیها را بین مراحل محاسباتی ایجاد میکند و معماریهای Mixture-of-Experts الگوهای ترافیک شبکه بسیار پویا را ایجاد میکنند، زیرا توکنها بین شبکههای خبره توزیع شده هدایت میشوند.
موضوع کلی این است که با توزیع بیشتر محاسبات، نیازمندیهای ارتباطی متناسب با آن رشد میکنند. این همچنین به این معنی است که درک دقیق نوع آموزش هوش مصنوعی برای پیشبینی الگوهای ترافیک و طراحی یک شبکه بهینهسازی مناسب حیاتی است.
در مراکز داده هوش مصنوعی در مقیاس کافی، ارتباطات جمعی به حجم کاری غالب در شبکه تبدیل می شود و در نهایت هزاران شتابدهنده فردی را به یک سیستم محاسباتی توزیع شده تبدیل می کند. آینده شبکههای هوش مصنوعی نه تنها با سرعتها و کانالهای سریعتر تعریف میشود، بلکه با این موضوع که چگونه شبکهها میتوانند به طور موثر از عملیات ارتباط جمعی که یادگیری و استنتاج هوش مصنوعی توزیع شده را هدایت میکنند، پشتیبانی کنند.
متشکرم
فیل